Domain bauerhöfe.de kaufen?
Wir ziehen mit dem Projekt
bauerhöfe.de um.
Sind Sie am Kauf der Domain
bauerhöfe.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain bauerhöfe.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Ökologische LandwirtschaftÖkologische Landwirtschaft , Die Ökologische Landwirtschaft hat sich zu einer stark wissensbasierten Wirtschaftsweise entwickelt. Für eine erfolgreiche Beschäftigung mit und in ihr braucht es vielfältige Kenntnisse. Die aktualisierte 2. Auflage vermittelt neben Spezialwissen auch Kenntnisse über Querbeziehungen zwischen den zahlreichen Wissensgebieten landwirtschaftlicher (Betriebs-)Systeme. Die neuen Kapitel zu den Themen Naturschutz, Klimawandel, Verbraucherakzeptanz und Internationaler Handel mit Ökoprodukten behandeln aktuelle Fragestellungen mit großer Relevanz für die Ökologische Landwirtschaft. Das neue Layout mit einem größeren Format und einer verbesserten Darstellung von Abbildungen und Tabellen erhöht die Lesefreundlichkeit und erleichtert das Lernen. Eine ideale Einführung insbesondere für Bachelor-Studierende der Agrarwissenschaften und angrenzender Studienrichtungen. , Ausbauwerkzeuge > Elektronikzubehör , Auflage: 2. aktual. und erweiterte Auflage, Erscheinungsjahr: 20220117, Produktform: Kartoniert, Redaktion: Wachendorf, Michael~Bürkert, Andreas~Graß, Rüdiger, Edition: REV, Auflage: 22002, Auflage/Ausgabe: 2. aktual. und erweiterte Auflage, Seitenzahl/Blattzahl: 376, Keyword: Agraringenieurwissenschaften; Agrarwissenschaft studieren; Artgerechte Tierhaltung; Biodiversität; Bioland; Boden; Bodenschutz; Demeter; Forstwirtschaft; Globale Klimawandeleffekte; Glyphosat; Handel mit Ökoprodukten; Klimarelevanz von Ökoprodukten; Klimawandel; Klimawandel und Landwirtschaft; Klimawandelanpassung; Landwirtschaft; Lehrbuch; Naturschutzmaßnahmen; Pflanzenbau; Produktionsfaktor Boden; Produktionsfaktor Kapital; Richtlinien der Ökologischen Landwirtschaft; Studium Agrarwissenschaft; Szenarien des Klimawandels; Zertifizierung; biologisch-dynamische Landwirtschaft; herkömmliche Landwirtschaft; Ökolandbau; Ökolandbau in den Subtropen; Ökolandbau in den Tropen; Ökolandwirt, Fachschema: Ökologie / Landwirtschaft, Ernährung~Umwelt / Tiere, Pflanzen~Ökologie~Forstwirtschaft~Wald / Waldwirtschaft, Fachkategorie: Ökologischer Landbau~Forstwirtschaft und Waldbau: Praxis und Techniken, Bildungszweck: für die Hochschule, Warengruppe: TB/Umwelt/Landwirtschaft, Gartenbau, Fachkategorie: Ökologie, Biosphäre, Thema: Verstehen, Text Sprache: ger, Originalsprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: UTB GmbH, Verlag: UTB GmbH, Verlag: UTB GmbH, Länge: 238, Breite: 169, Höhe: 25, Gewicht: 912, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Vorgänger EAN: 9783825248635, eBook EAN: 9783838555270, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch, WolkenId: 153757140,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ökologische LandwirtschaftÖkologische Landwirtschaft , Die Ökologische Landwirtschaft hat sich zu einer stark wissensbasierten Wirtschaftsweise entwickelt. Für eine erfolgreiche Beschäftigung mit und in ihr braucht es vielfältige Kenntnisse. Die aktualisierte 2. Auflage vermittelt neben Spezialwissen auch Kenntnisse über Querbeziehungen zwischen den zahlreichen Wissensgebieten landwirtschaftlicher (Betriebs-)Systeme. Die neuen Kapitel zu den Themen Naturschutz, Klimawandel, Verbraucherakzeptanz und Internationaler Handel mit Ökoprodukten behandeln aktuelle Fragestellungen mit großer Relevanz für die Ökologische Landwirtschaft. Das neue Layout mit einem größeren Format und einer verbesserten Darstellung von Abbildungen und Tabellen erhöht die Lesefreundlichkeit und erleichtert das Lernen. Eine ideale Einführung insbesondere für Bachelor-Studierende der Agrarwissenschaften und angrenzender Studienrichtungen. , Ausbauwerkzeuge > Elektronikzubehör , Auflage: 2. aktual. und erweiterte Auflage, Erscheinungsjahr: 20220117, Produktform: Kartoniert, Redaktion: Wachendorf, Michael~Bürkert, Andreas~Graß, Rüdiger, Edition: REV, Auflage: 22002, Auflage/Ausgabe: 2. aktual. und erweiterte Auflage, Seitenzahl/Blattzahl: 376, Keyword: Agraringenieurwissenschaften; Agrarwissenschaft studieren; Artgerechte Tierhaltung; Biodiversität; Bioland; Boden; Bodenschutz; Demeter; Forstwirtschaft; Globale Klimawandeleffekte; Glyphosat; Handel mit Ökoprodukten; Klimarelevanz von Ökoprodukten; Klimawandel; Klimawandel und Landwirtschaft; Klimawandelanpassung; Landwirtschaft; Lehrbuch; Naturschutzmaßnahmen; Pflanzenbau; Produktionsfaktor Boden; Produktionsfaktor Kapital; Richtlinien der Ökologischen Landwirtschaft; Studium Agrarwissenschaft; Szenarien des Klimawandels; Zertifizierung; biologisch-dynamische Landwirtschaft; herkömmliche Landwirtschaft; Ökolandbau; Ökolandbau in den Subtropen; Ökolandbau in den Tropen; Ökolandwirt, Fachschema: Ökologie / Landwirtschaft, Ernährung~Umwelt / Tiere, Pflanzen~Ökologie~Forstwirtschaft~Wald / Waldwirtschaft, Fachkategorie: Ökologischer Landbau~Forstwirtschaft und Waldbau: Praxis und Techniken, Bildungszweck: für die Hochschule, Warengruppe: TB/Umwelt/Landwirtschaft, Gartenbau, Fachkategorie: Ökologie, Biosphäre, Thema: Verstehen, Text Sprache: ger, Originalsprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: UTB GmbH, Verlag: UTB GmbH, Verlag: UTB GmbH, Länge: 238, Breite: 169, Höhe: 25, Gewicht: 912, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Vorgänger EAN: 9783825248635, eBook EAN: 9783838555270, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch, WolkenId: 153757140,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
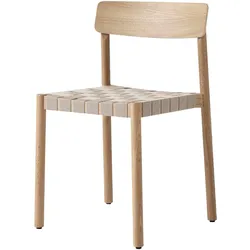
&Tradition Betty TK1 Stuhl, eiche natur / gewebe naturBetty TK1 Stuhl von &Tradition – skandinavischer Designklassiker mit Charakter Der Betty TK1 Stuhl von &Tradition überzeugt durch reduziertes Design, hochwertige Materialien und handwerkliche Details. Benannt nach dem historischen Betty Nansen Theater in Kopenhagen, steht dieser Stuhl für moderne Schlichtheit mit kulturellem Hintergrund. Entworfen von den Designern Jakob Thau und Sami Kallio, bringt er nordischen Stil und Natürlichkeit in Ihre Wohnung. Die Sitzfläche aus handgeflochtenem Leinengewebe sorgt nicht nur für angenehmen Komfort, sondern unterstreicht den hohen Anspruch an Material und Verarbeitung. Das Gestell aus massiver Eiche ist in verschiedenen Varianten erhältlich – ob in Natur, Schwarz oder geräuchert. Mit seinen Maßen von 51 x 48 x 77 cm (B x T x H) und einer Sitzhöhe von 47 cm passt der Stuhl perfekt an den Esstisch, in die Küche oder als stilvolles Einzelstück ins Wohnzimmer. Die Möglichkeit, ihn bis zu acht Mal zu stapeln, macht ihn auch für kleinere Räume und flexible Nutzung attraktiv. Design, Funktion und Stil – Betty TK1 für Ihr Zuhause Ob als eleganter Akzent im Essbereich oder als funktionales Möbelstück mit Geschichte – der Betty Stuhl TK1 fügt sich mühelos in jeden Einrichtungsstil ein. Wählen Sie Ihre bevorzugte Farbe und setzen Sie individuelle Akzente in Ihrem Zuhause. Dank durchdachtem Design und langlebigen Materialien ist dieser Stuhl nicht nur optisch ein Highlight, sondern auch praktisch und komfortabel im Alltag. Der Betty TK1 gehört zur gleichnamigen Kollektion von &Tradition und besticht durch seine offene, leichte Konstruktion, die sich perfekt mit verschiedenen Tischen, Möbeln und Textilien kombinieren lässt. Die natürlichen Oberflächen und die gewebte Sitzfläche machen ihn besonders in Kombination mit Eiche, Naturtönen oder minimalistischen Elementen zu einem stilvollen Hingucker. Als moderner Designklassiker passt er ebenso gut in moderne Wohnkonzepte wie in gemütliche Landhaus- oder Shabby-Chic-Umgebungen. Der Betty TK1 bringt skandinavisches Design und feinste Materialien in Einklang mit Alltagstauglichkeit und ästhetischer Raffinesse. Mehr zu &Tradition Stühlen finden Sie in unserer Kategorie.403,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.